5 моделей, 22 человека, 1 год


Fish Audio привлекла 52 млн долларов посевных инвестиций. Как хобби-проект на одной 4090 превратился в это, и что мы строим дальше. Читайте нашу историю.
Сегодня Fish Audio отмечает еще одну невероятную веху. В нашу первую годовщину мы объявляем о привлечении 52 млн долларов посевного финансирования. Спасибо Coreline Ventures и Capital Today, которые возглавили раунд, при участии 359 Capital, Play Time, HF0, 645 Ventures, Parable, Carya Venture Partners, Alphalist Partners и бизнес-ангелам, которые вложили средства, когда смотреть было еще особо не на что.
Технология преобразования текста в речь (TTS) была достаточно хороша в течение примерно десятилетия, если вам нужно было всего одно предложение. Проблемы становятся заметны на десятом. Вся категория терпит неудачу в одном и том же месте по той же причине: правильно передать слова и правильно передать интонацию — это разные задачи, и почти все работали только над первой.
Годы работы с голосовым ИИ в Amazon Alexa и Meta показали мне, где заканчиваются традиционные TTS-системы: голос, созданный для чтения, никогда не научится актерской игре. Поэтому мы начали с другого конца. Fish Audio — это не просто улучшенный голосовой помощник. Это голосовой слой для всего, что придет ему на смену.

4090
Шицзя Ляо (Shijia Liao), наш главный научный сотрудник, пришел к тому же выводу с другой стороны. Будучи инженером-исследователем в NVIDIA, работающим с видео, он проводил свободное время за просмотром стримов VTuber-ов и не мог смириться с тем, насколько безжизненно звучали их голоса. Он начал обучать модели на одной 4090 в своей спальне, сделав раннюю ставку на двойную авторегрессионную архитектуру, до которой остальная индустрия не доберется еще два года. Эта работа легла в основу S2.
Что мы сделали за 1 год
- Выпустили пять передовых аудиомоделей: четыре для преобразования текста в речь, одну для преобразования речи в текст.
- Увеличили команду с 3 до 22 человек и продолжаем нанимать сотрудников.
- От нуля до 21 млн долларов ежегодной регулярной выручки.
- Более 8 млн креаторов, разработчиков и корпоративных клиентов на платформе.
- Более 2 млн голосовых моделей в библиотеке сообщества.
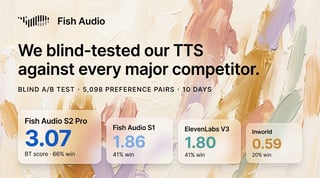
- S2.1 Pro — 66% слушателей предпочли эту модель решениям ведущих конкурентов в слепых тестах.
- Более 83 языков с естественной интонацией и контролем эмоций на уровне слов через 15 000+ элементов управления на естественном языке.
Сообщество создало модель
Мы проводим постобучение на основе реальных предпочтений пользователей, а это значит, что модель становится лучше, когда люди используют ее чаще. Вот почему мы лидируем в английском с акцентом, мандаринском, японском, корейском и испанском языках, где модели, обученные в основном на стандартном американском английском, терпят неудачу. Эта способность появилась благодаря людям, использующим инструмент на языках, с акцентами и в пограничных случаях, о тестировании которых мы бы никогда не подумали.
Fish Speech превратился из репозитория в компанию благодаря разработчикам игр, фанатам аниме и людям, озвучивающим персонажей ради удовольствия. С самого начала мы верили в прозрачность и открытость, а также в то, что выразительный и высококачественный голосовой ИИ должен быть доступен каждому.
И восемь миллионов из вас доверили нам это.
Модель, которой теперь доверяет бизнес
Это доверие — причина, по которой корпоративный сектор также обращается к Fish Audio. Вместе с разработчиками предприятия теперь приносят две трети нашей выручки.
Мы обеспечиваем им стабильную работу, низкую задержку и уровень безопасности, который проходит любые проверки: развертывание on-premises, политику нулевого хранения данных и конфигурации, соответствующие стандартам HIPAA, заложенные с самого начала. S2.1 Pro уже побеждает в слепых тестах против ведущих моделей, работает со скоростью более 8 000 токенов в секунду на одной H200 и стабильно работает на языках, где модели, настроенные под один диалект, тихо выходят из строя.
Корпоративные клиенты приходят к нам, потому что правильная подача интонации, а не просто слов — это именно та проблема, которую мы ставили перед собой. И теперь у нас есть возможность продвинуться в этой миссии еще дальше.
Что дальше?
Преобразование текста в речь никогда не было конечной целью. Это была часть, которую мы могли построить первой с помощью одного графического процессора и доказать теорию: подача имеет такое же значение, как и слова, и никто до нас не решал эту задачу.
Теперь мы беремся за остальную часть стека. Языковая модель понимания звука (Audio LM) и преобразование речи в речь. Мы также удваиваем ставку на инструменты для разработчиков и API, расширяем корпоративную команду и углубляем партнерство с такими компаниями, как LiveKit и Retell, чтобы внедрять выразительный голос в большее количество мест еще быстрее.
Бесплатно до конца августа
Чтобы отпраздновать эту важную веху, S2.1 Pro будет доступен бесплатно для всех разработчиков через API до конца августа. Это та же модель, за которую платят наши корпоративные клиенты. Мы также предлагаем скидку 50% на тарифные планы для креаторов и 3 месяца бесплатно при переходе от другого провайдера.
Мы можем это сделать по техническим причинам, и это заслуга нашей исследовательской группы. В этом году они полностью перестроили наш стек инференса: кастомные ядра FP8, более 8 000 токенов в секунду на одной H200. Это позволило снизить стоимость запроса настолько, что бесплатное предоставление модели стало успешной стратегией.
Спасибо
Год назад Fish Audio была хобби-проектом в нашей гостиной. Каждый, кто обучал голос, озвучивал персонажа, создавал что-то на базе API или верил в нас, когда еще особо не во что было верить — это достижение принадлежит вам так же, как и нам.
На этом пути мы во многом ошибались. Теперь у нас скоро появятся ресурсы, чтобы сделать правильно гораздо больше вещей.
За второй год!
Rissa is the CEO and co-founder of Fish Audio, pushing breakthroughs in AI voice technology. Find her latest work at @rissa_cao.
Читать больше от Rissa Cao