Ferramenta de Transcrição de Podcast — Como Transcrever seu Podcast com o Fish Audio

A ferramenta de transcrição de podcast do Fish Audio converte áudio em texto com etiquetas automáticas de emoção, rótulos de locutor e marcações de tempo — depois exporta para SRT, VTT ou JSON. Plano gratuito disponível. Sem necessidade de código.
Março de 2026 | Fish Audio STT já está disponível em fish.audio/app/speech-to-text
Cada episódio de podcast que você publica sem uma transcrição está perdendo tráfego. Uma transcrição torna seu episódio pesquisável no Google, oferece notas do programa (show notes) em um clique e permite gerar legendas automaticamente — para o YouTube, seu site ou qualquer outro lugar onde você distribua. Para públicos com deficiência auditiva, também torna seu conteúdo acessível. Editores de podcast, equipes de mídia e criadores do YouTube dependem de transcrições para gerar conteúdo para SEO, arquivos pesquisáveis e páginas de episódios acessíveis. A maioria das ferramentas de transcrição de podcast entrega apenas um bloco de texto simples. A ferramenta de transcrição de podcast do Fish Audio vai além: cada transcrição vem com etiquetas automáticas de emoção e paralinguagem, rótulos de locutor, marcações de tempo e três formatos de exportação. Este guia orienta você por todo o fluxo de trabalho, do upload à exportação, em cerca de três minutos.
O Que Torna uma Ferramenta de Transcrição de Podcast Boa?
Antes de escolher qualquer ferramenta de transcrição, ajuda saber o que você está avaliando de fato. Uma boa ferramenta de transcrição de podcast deve oferecer quatro coisas:
-
Alta precisão de transcrição em diferentes sotaques, qualidades de áudio e ambientes de gravação
-
Identificação de locutor para que você possa distinguir o apresentador do convidado na transcrição
-
Múltiplos formatos de exportação — no mínimo SRT para legendas de vídeo e, idealmente, VTT e JSON também
-
Preços transparentes e acessíveis com um plano gratuito que seja realmente utilizável para um episódio real
A ferramenta de transcrição de podcast do Fish Audio suporta mais de 100 idiomas, aceita 24 formatos de áudio e vídeo e etiqueta automaticamente eventos de emoção e paralinguagem diretamente no texto — sem qualquer anotação manual. O modelo de fala para texto (speech-to-text) é otimizado para áudio conversacional e gravações com múltiplos interlocutores, como podcasts, entrevistas e discussões ao vivo. Veja como funciona na prática.
Como Transcrever seu Podcast com o Fish Audio — Passo a Passo
Tempo necessário: ~3 minutos Ferramentas necessárias: Arquivo de áudio (MP3, MP4, WAV, M4A e outros) Resultado: Transcrição etiquetada + arquivo de legenda pronto para exportação
Passo 1 — Abra o Fish Audio STT
Vá para fish.audio/app/speech-to-text. Você verá seu histórico de tarefas — todas as transcrições anteriores listadas com nome do arquivo, data, status, créditos usados e contagem de locutores. Clique em Create task para iniciar uma nova transcrição.
Passo 2 — Faça o upload do seu episódio e defina os locutores
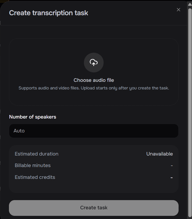
Na janela Create transcription task, faça o upload do seu arquivo de áudio ou vídeo. O Fish Audio aceita todos os principais formatos — MP3, MP4, WAV, FLAC, M4A, OGG, MOV, AVI, WEBM e mais.
Em number of speakers, deixe em Auto se não tiver certeza de quantas pessoas estão na gravação. O Fish Audio detectará os locutores automaticamente. Se você souber o número exato — por exemplo, dois para um formato padrão de apresentador e convidado — você pode configurá-lo manualmente para rótulos de locutor mais precisos.
Antes de confirmar, a interface mostra a duração estimada, minutos faturáveis e créditos estimados para esta tarefa. Você não será cobrado até clicar em Create task.
Passo 3 — Revise sua transcrição
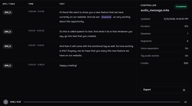
Assim que a tarefa for concluída, clique em Open viewer. A transcrição é exibida em três colunas: SPK/TAGS (rótulo do locutor), TIME (intervalo de tempo) e TEXT (a transcrição com etiquetas no texto).
Cada segmento possui marcação de tempo precisa até o segundo. Eventos de emoção e paralinguagem aparecem como etiquetas roxas diretamente dentro do texto — você verá itens como [pause], [sigh], [emphasis] e [breath] no ponto exato da gravação em que ocorreram.
Clique em qualquer segmento para reproduzir essa parte do áudio diretamente no navegador. Isso facilita a verificação da precisão ou a checagem de momentos específicos sem precisar percorrer todo o arquivo.
O painel Controller à direita mostra um resumo: duração total, número de locutores detectados, número de segmentos e a confirmação de que a separação de voz e a etiqueta de eventos de áudio (Tag audio events) estão ativadas.
Passo 4 — Exporte no seu formato
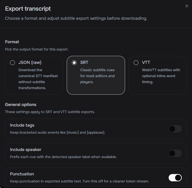
Clique em Export no canto inferior direito do painel Controller. Escolha seu formato e configure as opções de exportação antes de baixar.
Pronto para transcrever seu primeiro episódio? Inicie uma tarefa de transcrição gratuita →
Etiquetas Automáticas — O Que o Fish Audio Captura que Outras Ferramentas Perdem
É aqui que a ferramenta de transcrição de podcast do Fish Audio se diferencia mais claramente das alternativas.
Quando alguém suspira antes de responder a uma pergunta, ri no meio de uma frase, faz uma pausa para dar ênfase ou respira audivelmente — as ferramentas de transcrição padrão ignoram tudo isso. Você recebe as palavras, despidas de todo o resto.
O Fish Audio incorpora esses eventos como etiquetas integradas no ponto exato em que ocorrem na transcrição. Essas etiquetas são geradas automaticamente — sem anotação manual, sem etapa de pós-processamento. O painel Controller mostra Tag audio events: On por padrão.
O que é etiquetado
Paralinguagem — sons não verbais que ocorrem juntamente com a fala.
Emoção — tom afetivo da entrega, capturado a partir do contexto e da prosódia.
Por que isso importa para podcasters
Para a maioria dos fluxos de trabalho de podcast, as etiquetas servem a três propósitos práticos. Primeiro, elas tornam sua transcrição mais útil como fonte para Notas do Episódio — uma transcrição que captura [laugh] e [pause] oferece ao seu editor um material muito mais rico do que um arquivo de texto plano. Segundo, elas tornam a navegação em gravações longas mais rápida — você pode procurar por momentos de [sigh] ou [emphasis] para encontrar partes emocionalmente significativas do episódio sem precisar ouvir tudo novamente. Terceiro, e de forma mais distinta, essas etiquetas são compatíveis com o modelo TTS do Fish Audio — o que significa que uma transcrição pode alimentar diretamente um fluxo de produção de voz sem qualquer reformatação.
Quer ver as etiquetas em ação? Faça o upload do seu primeiro arquivo de áudio →
Formatos de Exportação Explicados — De Qual Você Precisa?
O Fish Audio STT suporta três formatos de exportação. Qual deles usar depende do que você fará com a transcrição em seguida.
SRT é a escolha certa para a maioria dos podcasters que distribuem conteúdo em vídeo. É o formato de legenda mais amplamente suportado — compatível com YouTube, Premiere Pro, Final Cut Pro e a maioria das plataformas de vídeo.
VTT (WebVTT) é o formato nativo para web — use-o quando estiver incorporando vídeo em seu próprio site e precisar de temporização de palavras integrada.
JSON fornece a saída bruta do STT sem as transformações de legenda. Use isso se estiver alimentando a transcrição em outra ferramenta ou criando algo personalizado.
Opções de exportação
Ao exportar SRT ou VTT, você tem quatro configurações adicionais:
-
Include tags — mantém eventos entre colchetes como
[pause]e[sigh]no arquivo de legenda. Desative para legendas limpas; deixe ativado se quiser preservar os metadados expressivos. -
Include speaker — prefixa cada legenda com o rótulo do locutor detectado (SPK_0, SPK_1). Útil para episódios com vários participantes.
-
Punctuation — mantém a pontuação no texto exportado. Desative para um fluxo de tokens mais limpo se for realizar processamento posterior.
-
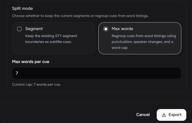
Split mode — escolha entre Segment (mantém os limites existentes do STT) ou Max words (reagrupa as legendas por contagem de palavras, pontuação e mudanças de locutor). O modo Max words com um limite de 7 palavras por legenda tende a produzir legendas mais legíveis para falas rápidas.
Detecção de Locutor — Distinguindo o Apresentador do Convidado
Para entrevistas de podcast e mesas-redondas, a detecção de locutor é um dos recursos mais úteis que uma ferramenta de transcrição de podcast pode oferecer. O Fish Audio separa automaticamente os locutores em gravações com várias pessoas. Cada segmento no visualizador de transcrição é rotulado como SPK_0, SPK_1 e assim por diante — correspondendo às vozes distintas detectadas no áudio.
Ao criar uma tarefa, você pode deixar o number of speakers em Auto ou configurá-lo manualmente. Definir o número exato tende a produzir limites de locutor mais precisos, especialmente em gravações onde um locutor fala significativamente mais baixo que o outro.
Ao exportar, ativar Include speaker adiciona o rótulo do locutor como um prefixo para cada legenda. Isso torna simples pesquisar, editar ou reformatar transcrições por locutor — útil se você estiver extraindo citações para Notas do Episódio ou editando uma transcrição para destacar trocas importantes.
Nota: A detecção de locutor e as transcrições rotuladas estão disponíveis na interface web do Fish Audio. Os rótulos de locutor são mantidos na exportação nos formatos SRT, VTT e JSON quando a opção Include speaker está ativada.
Quanto Custa Transcrever um Podcast?
O Fish Audio STT é cobrado por minuto de áudio processado a 300 créditos por minuto.
Contas gratuitas recebem 8.000 créditos por mês — o suficiente para aproximadamente 26 minutos de áudio. Isso cobre um episódio de formato curto ou alguns segmentos de entrevista.
A interface web mostra a estimativa exata de créditos antes de você confirmar uma tarefa, para que não haja surpresas.
Para equipes ou produções de alto volume, os planos pagos incluem pacotes de créditos maiores. Veja a tabela completa de preços em fish.audio/plan/.
Transcreva seu próximo episódio de podcast em minutos. Comece a transcrever gratuitamente →
Fish Audio vs Outras Ferramentas de Transcrição de Podcast
Muitos podcasters que buscam a melhor ferramenta de transcrição descobrem que a escolha certa depende de precisarem de transcrições em texto simples ou de metadados mais ricos, como etiquetas de emoção e exportação em vários formatos. Veja como o Fish Audio se compara a outras opções populares:
| Recurso | Fish Audio | Otter.ai | Happy Scribe | Adobe Podcast |
|---|---|---|---|---|
| Etiquetas auto. de emoção | ✅ | ❌ | ❌ | ❌ |
| Etiquetas paralinguagem | ✅ | ❌ | ❌ | ❌ |
| Detecção de locutor | ✅ | ✅ | ✅ | ✅ |
| Exportação SRT | ✅ | ✅ | ✅ | ❌ |
| Exportação VTT | ✅ | ❌ | ✅ | ❌ |
| Exportação JSON | ✅ | ❌ | ❌ | ❌ |
| Integração TTS / Studio | ✅ | ❌ | ❌ | ❌ |
| Idiomas | 100+ | Multi-idioma | 120+ | Limitado |
| Plano gratuito | ✅ 8.000 créd./mês | ✅ 300 min/mês | ✅ limitado | ✅ |
Dados obtidos de Otter.ai, Happy Scribe* e * Adobe Podcast em março de 2026.
A maioria das ferramentas de transcrição de podcast foca em entregar resultados em texto simples. O Fish Audio é um dos poucos que incorpora etiquetas de emoção e paralinguagem diretamente na transcrição — e uma das poucas ferramentas que conecta a transcrição a um fluxo de produção de voz via integração com o Studio.
Se você precisa de texto simples e limpo para notas do programa ou conteúdo de SEO, qualquer uma dessas ferramentas funcionará. Se você precisa de transcrições etiquetadas, exportação multiformato ou um caminho da transcrição para a produção de voz, o Fish Audio é a opção mais completa.
Outra opção útil para podcasters é o Podsqueeze, uma plataforma de IA que ajuda a transformar episódios de podcast em notas do programa, marcações de tempo, resumos, posts sociais, newsletters e outros conteúdos reaproveitados. É especialmente útil para criadores que desejam economizar tempo após a gravação e transformar cada episódio em múltiplos ativos de conteúdo para seu público.
Próximos Passos — Da Transcrição ao Studio
Uma transcrição etiquetada é mais do que um documento. É um roteiro que já sabe como deve soar.
As etiquetas que o Fish Audio incorpora na sua transcrição de podcast — [calm, reflective], [breath], [determined], [pause] — usam o mesmo formato do modelo S2 TTS do Fish Audio. Isso significa que uma transcrição pode alimentar diretamente uma linha de produção de voz sem qualquer reformatação.
O Fish Audio Studio leva isso adiante. No Studio, roteiros etiquetados tornam-se projetos de voz totalmente editáveis: você pode editar por capítulo, trocar modelos de voz, ajustar a entrega no nível da palavra e produzir áudio multifaixa — tudo com os metadados expressivos da sua gravação original intactos.
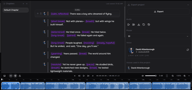
A importação direta do STT para o Studio é um recurso que chegará em breve. O formato da transcrição já é compatível — as etiquetas na sua saída STT são as mesmas etiquetas que o Studio lê. A importação será um passo único assim que o recurso for lançado.
Comece a transcrever seu podcast gratuitamente → — ou Explore o Fish Audio Studio se estiver pronto para produzir.
Relacionado:
Perguntas Frequentes
Qual é a melhor ferramenta gratuita de transcrição de podcast?
Quão precisa é a ferramenta de transcrição de podcast do Fish Audio?
O Fish Audio consegue transcrever múltiplos locutores?
Quais formatos de exportação o Fish Audio suporta?
Quanto tempo leva a transcrição?
Posso usar o Fish Audio STT sem uma conta?
Quais idiomas o Fish Audio suporta?
Quais formatos de áudio o Fish Audio aceita?
Sabrina is part of Fish Audio's support and marketing team, helping users get the most out of AI voice products while turning launches, updates, and customer insights into clear, practical content.
Leia mais de Sabrina Shu