Fish Audio S2.1 Pro:面向开发者的免费文字转语音 API


快速摘要:
S2.1 Pro 是 Fish Audio 最先进的语音模型,现已作为免费文字转语音 API 提供
支持 83 种语言,在公平使用政策下可无限量使用
模型字符串:s2.1-pro-free —— 直接放入您现有的 Fish API 调用中即可使用
免费试用 S2.1 Pro —— 5 分钟内生成首段音频 →
2026 年 6 月 | Fish Audio 的 S2.1 Pro 模型现已作为免费文字转语音 API 提供,在公平使用原则下可无限量访问。
为什么高质量语音 AI 一直以来都价格昂贵
如果您曾花时间评估过文字转语音 API,您一定知道这个规律:真正好听的模型都要花钱。
ElevenLabs 的免费层级每月提供 10,000 个字符额度(约 6 - 10 分钟),之后便会触发付费墙。OpenAI TTS 采用按需付费模式,完全没有免费层级。Google 最新的 Gemini TTS 模型 —— 他们最先进的模型 —— 没有免费试用额度:从第一个 token 开始就要收费。整个行业的规律非常一致:顶尖的语音质量一直是一项付费功能。
这给开发者带来了真正的难题。AI 语音生成市场正以每年近 20% 的速度增长 —— 但构建语音产品的工具却被锁在付费墙后。您无法仅通过 10,000 个字符来正确评估一个模型。如果不预先投入预算,或者花数周时间折腾需要自行搭建 GPU 基础设施的开源替代方案,您就无法完成语音智能体的原型开发、测试有声读物流水线或实验语音克隆。
Fish Audio 今天正在改变这一现状。
什么是 S2.1 Pro?

S2.1 Pro 是 Fish Audio 目前最先进的语音模型 —— 这是我们拥有的最好的模型,现在通过 API 免费向所有开发者开放。它是一款为生产级 AI 语音生成而设计的神经语音合成模型,在低延迟流式传输、多语言 TTS 和语音克隆方面具有显著优势。它建立在我们今年早些时候开源权重的 S2 基础之上。
性能表现
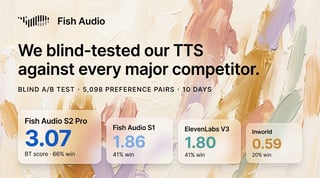
- 在面对面的听感评估中,对比上一代 S2 Pro 的胜率为 61% —— 详情请参阅我们的 TTS 供应商盲测对比
- 单次请求的首包时间 (TTFA) 约为 70ms —— 低于上一代的约 100ms
- 高并发负载下的吞吐量提升了 2 倍以上
有关完整的技术背景,请参阅我们的论文:点击此处
语言覆盖
S2.1 Pro 支持 83 种语言,包括英语、日语、中文、韩语、西班牙语、阿拉伯语、法语、德语、葡萄牙语、俄语等数十种语言。同一个模型即可处理所有语言 —— 无需分开的端点,也没有按语言计费的差异。
延迟
S2.1-Pro 在标准 API 上提供约 90ms 的 TTFA(首包时间),使其能够胜任实时语音智能体和轮替对话系统。如果您需要对抑扬顿挫和表达进行精细控制,请参阅 S2 的单词级语音控制功能。
为什么 Fish Audio 现在可以免费提供此项服务

简而言之:我们从底层重构了推理栈,使得单次请求的成本显著降低,降到了我们可以自行承担的程度。
自定义 GPU 核 (Kernels)
我们开发了 fish-scales-ops,这是一个针对 NVIDIA Hopper (H100/H200) 和 Blackwell (RTX 6000 PRO) 架构的生产级 FP8 GEMM 和 FlashAttention 库。在语音 AI 服务所需的解码形状上,我们的 MXFP8 路径性能优于 torch.compile-fused cuBLAS 参考实现 2.1–4.3 倍。您在使用 API 时无需了解这些细节 —— 但这正是免费层级能够持续运行的原因。
更高的吞吐量
在具有 FP8 量化的单台 H200 上,系统在 64 个并发请求下可维持超过 8,000 token/秒的输出吞吐量。每个 GPU 的吞吐量越高,意味着每美元能服务的请求越多,这正是让无限量免费访问在经济上变得可行的关键。
“免费”究竟意味着什么
与其将限制隐藏起来,我们宁愿坦诚布公。
您将获得:
- 模型字符串:
s2.1-pro-free - 高容量访问,无字符硬性限制(受公平使用政策约束)
- 与付费计划相同的 API 端点 —— 无需额外集成
目前的限制:
- 持续时间:
免费访问有效期至 2026 年 7 月 24 日 免费访问有效期至 2026 年 7 月底 免费访问有效期至 2026 年 8 月 31 日免费访问有效期至 2026 年 11 月 30 日 —— 如有任何变动,我们将提前通知。- 更新(2026 年 6 月): 我们正在延长免费窗口以覆盖整个 7 月。我们希望开发者能有一个完整、不间断的月份来进行构建、评估和发布 —— 而不是忙着为截止日期倒计时。
- 更新(2026 年 7 月): 我们再次延长免费访问时间,直至 2026 年 8 月 31 日。看到我们的开发者使用 S2.1 Pro 构建的成果确实令人心暖,我们希望为这种势头提供更大的增长空间。
- 无 SLA: 不提供在线率/TTFA 保证;专为实验和原型设计而构建
- 无延迟保证: 尽力而为,非合同约定
- 数据保留: 请求数据可能会被用于提升模型质量 —— 请参阅我们的隐私政策
- 商业用途: 某些商业场景可能会有限制。年度经常性收入 (ARR) 超过 100 万美元的产品在调用 S2.1 Pro 免费版前应与我们联系。详情请参阅定价与频率限制。
如果您需要生产级 SLA 和延迟保证,我们提供付费方案。目前的免费层级是构建、评估和做决定的理想起点。
如何使用免费文字转语音 API:S2.1 Pro 快速入门
在 fish.audio/app/api-keys 获取您的 API 密钥,然后发起您的第一次调用。Fish API 接受 msgpack 编码的请求,并以您选择的格式返回音频。完整参考请见 API 文档。
JavaScript
import { writeFile } from "fs/promises";

const body = {
  text: "Hello, world!",
  reference_id: "your_model_id",
  format: "mp3",
};

const res = await fetch("https://api.fish.audio/v1/tts", {
  method: "POST",
  headers: {
    Authorization: "Bearer <YOUR_API_KEY>",
    "Content-Type": "application/json",
    model: "s2.1-pro-free",
  },
  body: JSON.stringify(body),
});

if (!res.ok) {
  throw new Error(`TTS request failed: ${res.status} ${await res.text()}`);
}

const buffer = Buffer.from(await res.arrayBuffer());
await writeFile("output.mp3", buffer);
Python
import httpx

body = {
    "text": "Hello, world!",
    "reference_id": "your_model_id",
    "format": "mp3",
}

with httpx.Client() as client:
    res = client.post(
        "https://api.fish.audio/v1/tts",
        headers={
            "Authorization": "Bearer <YOUR_API_KEY>",
            "Content-Type": "application/json",
            "model": "s2.1-pro-free",
        },
        json=body,
    )

res.raise_for_status()

with open("output.mp3", "wb") as f:
    f.write(res.content)
与任何其他 Fish Audio API 调用的唯一区别:在 header 中设置 model: "s2.1-pro-free" 即可。就这么简单。
S2.1 Pro vs ElevenLabs 以及 2026 年最佳 TTS API
以下竞争对手信息基于截至 2026 年 6 月的公开文档和定价页面。价格和功能可能会发生变化 —— 在做出生产决策前,请直接向各供应商核实。

如需更深入的独立分析,请参阅我们的 TTS 供应商盲测对比。
结论:在我们评估的主要 TTS API 供应商中,Fish Audio 目前提供了最慷慨的免费访问模型 —— 这是唯一一个免费层级运行与付费层级相同的先进模型,且没有字符硬上限的模型。ElevenLabs 的免费层级实际上是只有 10,000 字符额度的试用版。Google 最先进的 TTS (Gemini TTS) 完全没有免费层级。
在寻找不牺牲模型质量的 ElevenLabs 免费替代方案? S2.1 Pro 现已开放,且无使用上限。
在寻找 OpenAI TTS 的免费替代方案? OpenAI 的 TTS 产品没有免费层级 —— S2.1 Pro 是首选的评估方案。
您可以用它构建什么
免费层级对使用场景没有限制。以下是 S2.1 Pro 结合低延迟 AI 语音生成、多语言支持和语音克隆功能可以发挥最大作用的场景。
语音智能体
实时对话 AI 的成败取决于延迟。S2.1 Pro 在标准调用下约 90ms 的 TTFA 速度足够快,足以支撑自然的轮替对话。将其与语音转文本层和 LLM 配对,即可构建完整的语音流水线,且无需按字符计费。您还可以通过我们的 MCP 和智能体技能支持 将 S2.1 Pro 集成到智能体工作流中。
有声读物和长篇叙述
83 种语言的支持和自然的韵律使 S2.1 Pro 非常适合有声读物制作和长篇语音合成。无限量使用意味着您可以处理完整的手稿,而无需盯着字符计数器或预先购买额度。
语音克隆
S2.1 Pro 支持通过 API 进行从参考音频克隆语音 —— 只需传入参考音频样本,模型即可用该声音合成语音。您可以构建个性化的语音应用,以一致的说话人身份本地化内容,或为游戏和动画生成角色声音。语音克隆在免费层级可用,同样受公平使用政策约束。
多语言应用
如果您的应用服务于多种语言的用户,使用单个一致的 AI 语音 API 覆盖 83 种语言,相比于那些每种语言都需要单独模型端点或对非英语语音合成收取溢价的替代方案,能显著简化开发流程。
游戏 NPC 对话
游戏音频流水线受益于高吞吐量和可预测的单次请求成本。无限量免费使用使得在开发阶段生成大型对话库并自由迭代变得非常实际,而无需在早期就投入生产预算。
可通过我们的合作伙伴生态系统获取
S2.1 Pro 也可以通过越来越多的合作伙伴平台获取,包括 Runware、Retell、Sierra 等。
如果您已经在这些平台上进行构建,无需额外的集成或设置即可访问 S2.1 Pro —— 直接使用现有环境即可。
我们正在积极扩展合作伙伴网络。如果您是平台或基础设施提供商,并有兴趣集成 S2.1 Pro,请联系我们的团队以探索合作可能。
公平使用政策与未来计划
免费层级在公平使用政策下运行。我们保留对看起来像滥用而非正常开发的模式进行限流或限制访问的权利 —— 我们的目标是保护整个开发者社区的访问权限,而不是为合法的用例设置人为限制。详情请参阅定价与频率限制。
一些值得期待的事情:
- 免费访问现已开放,初始阶段会持续一段时间。如有任何变动,我们将提前通知。
- 付费计划提供 SLA 保证、延迟承诺和商业许可,适用于生产负载。
- 基础设施投入是持续的 —— 实现免费层级的工程工作不是一次性的。
- 开源基础设施: 我们计划开源 S2.1 Pro 背后的基础设施组件 —— 正是这一套技术栈让免费层级得以持续。
如果您正在评估将 Fish Audio 用于生产部署,免费层级是理想的起点。构建一些真实的东西,测量对您的应用重要的指标,并在准备好讨论生产需求时联系我们。
无需信用卡。无需排队。您的尝试不设限。
常见问题解答
什么是文字转语音 API?
Fish Audio S2.1 Pro 真的免费吗?
2026 年最好的免费 TTS API 是哪个?
Fish Audio 与 ElevenLabs 相比如何?
Fish Audio 支持语音克隆吗?
我可以将 Fish Audio 用于商业用途吗?
Fish Audio 支持哪些语言?