팟캐스트 전사 도구 — Fish Audio로 팟캐스트를 텍스트로 변환하는 방법

Fish Audio의 팟캐스트 전사 도구는 자동 감정 태그, 화자 레이블, 타임스탬프와 함께 오디오를 텍스트로 변환하며, 이후 SRT, VTT 또는 JSON으로 내보낼 수 있습니다. 무료 티어가 제공되며 코딩 지식이 필요하지 않습니다.
2026년 3월 | Fish Audio STT가 이제 fish.audio/app/speech-to-text에서 운영 중입니다.
전사본 없이 게시하는 모든 팟캐스트 에피소드는 유입될 수 있는 트래픽을 놓치고 있는 것과 같습니다. 전사본은 에피소드를 Google에서 검색 가능하게 만들고, 클릭 한 번으로 쇼 노트를 제공하며, YouTube나 웹사이트 등 배포하는 모든 플랫폼에서 자막을 자동으로 생성할 수 있게 해줍니다. 또한 청각 장애가 있는 시청자에게 콘텐츠 접근성을 제공합니다. 팟캐스트 편집자, 미디어 팀, YouTube 크리에이터는 SEO 콘텐츠 생성, 검색 가능한 아카이브 구축, 접근성 높은 에피소드 페이지 제작을 위해 전사본을 활용합니다. 대부분의 팟캐스트 전사 도구는 단순한 텍스트 뭉치만 제공하고 끝납니다. Fish Audio의 팟캐스트 전사 도구는 한 걸음 더 나아갑니다. 모든 전사본에 자동 감정 및 준언어 태그, 화자 레이블, 타임스탬프를 포함하며 세 가지 내보내기 형식을 지원합니다. 이 가이드는 업로드부터 내보내기까지 약 3분 내에 완료되는 전체 워크플로우를 안내합니다.
좋은 팟캐스트 전사 도구의 기준은 무엇일까요?
전사 도구를 선택하기 전에 실제로 무엇을 평가해야 하는지 아는 것이 도움이 됩니다. 좋은 팟캐스트 전사 도구는 다음 네 가지를 제공해야 합니다.
-
다양한 억양, 오디오 품질 및 녹음 환경 전반에 걸친 높은 전사 정확도
-
전사본에서 진행자와 게스트를 구분할 수 있는 화자 식별
-
다양한 내보내기 형식 — 최소한 비디오 자막용 SRT, 가급적 VTT와 JSON까지 지원
-
실제 에피소드에 충분히 활용 가능한 무료 티어를 포함한 투명하고 저렴한 가격
Fish Audio의 팟캐스트 전사 도구는 100개 이상의 언어를 지원하고 24가지 오디오 및 비디오 형식을 수용하며, 수동 작업 없이 텍스트 내에 감정 및 준언어 이벤트를 자동으로 태그합니다. 이 음성 인식(STT) 모델은 대화형 오디오와 팟캐스트, 인터뷰, 라이브 토론과 같은 다중 화자 녹음에 최적화되어 있습니다. 실제 작동 방식은 다음과 같습니다.
Fish Audio로 팟캐스트 전사하기 — 단계별 가이드
소요 시간: 약 3분 필요한 도구: 오디오 파일 (MP3, MP4, WAV, M4A 등) 출력물: 태그가 포함된 전사본 + 내보내기 준비가 된 자막 파일
1단계 — Fish Audio STT 열기
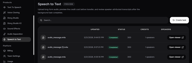
fish.audio/app/speech-to-text로 이동합니다. 파일 이름, 날짜, 상태, 사용된 크레딧, 화자 수와 함께 이전의 모든 전사 내역이 표시됩니다. Create task를 클릭하여 새로운 전사 작업을 시작합니다.
2단계 — 에피소드 업로드 및 화자 설정
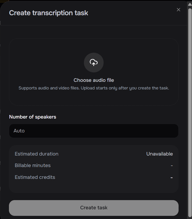
전사 작업 생성(Create transcription task) 창에서 오디오 또는 비디오 파일을 업로드합니다. Fish Audio는 MP3, MP4, WAV, FLAC, M4A, OGG, MOV, AVI, WEBM 등 모든 주요 형식을 지원합니다.
number of speakers(화자 수) 설정에서 녹음에 몇 명이 있는지 확실하지 않은 경우 'Auto'로 둡니다. Fish Audio가 자동으로 화자를 감지합니다. 표준 진행자-게스트 형식과 같이 정확한 인원수(예: 2명)를 알고 있다면 더 정확한 화자 레이블을 위해 수동으로 설정할 수 있습니다.
확인하기 전에 인터페이스에 예상 소요 시간, 청구 가능 시간 및 이 작업에 필요한 예상 크레딧이 표시됩니다. Create task를 클릭하기 전까지는 크레딧이 차감되지 않습니다.
3단계 — 전사본 검토
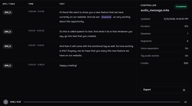
작업이 완료되면 Open viewer를 클릭합니다. 전사본은 SPK/TAGS(화자 레이블), TIME(타임스탬프 범위), TEXT(인라인 태그가 포함된 전사 텍스트)의 세 가지 열로 표시됩니다.
모든 세그먼트는 초 단위까지 타임스탬프가 찍힙니다. 감정 및 준언어 이벤트는 텍스트 내에 보라색 인라인 태그로 나타납니다. 녹음 중 해당 현상이 발생한 정확한 지점에 [pause], [sigh], [emphasis], [breath]와 같은 태그가 표시됩니다.
임의의 세그먼트를 클릭하면 브라우저에서 해당 부분의 오디오를 즉시 재생할 수 있습니다. 이를 통해 전체 파일을 훑어보지 않고도 정확성을 확인하거나 특정 순간을 점검하기가 매우 쉽습니다.
우측의 컨트롤러(Controller) 패널에는 총 시간, 감지된 화자 수, 세그먼트 수 요약이 표시되며 음성 분리(voice separation) 및 오디오 이벤트 태그(Tag audio events) 기능이 켜져 있음을 확인할 수 있습니다.
4단계 — 원하는 형식으로 내보내기
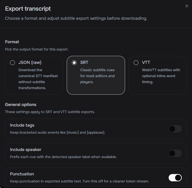
컨트롤러 패널 오른쪽 하단의 Export를 클릭합니다. 다운로드하기 전에 형식을 선택하고 내보내기 옵션을 설정합니다.
첫 에피소드를 전사할 준비가 되셨나요? 무료 전사 작업 시작하기 →
자동 태그 — Fish Audio가 포착하는 다른 도구의 누락 요소
이 부분은 Fish Audio의 팟캐스트 전사 도구가 대안들과 가장 명확하게 차별화되는 지점입니다.
누군가 질문에 답하기 전 한숨을 쉬거나, 문장 중간에 웃거나, 강조를 위해 멈추거나, 가쁜 숨을 들이쉴 때 표준 전사 도구들은 이 모든 것을 무시합니다. 그저 다른 모든 요소가 제거된 텍스트만 얻게 됩니다.
Fish Audio는 이러한 이벤트를 전사본의 정확한 발생 지점에 인라인 태그로 삽입합니다. 이 태그들은 수동 주석이나 사후 처리 단계 없이 자동으로 생성됩니다. 컨트롤러 패널에는 기본적으로 Tag audio events: On이 설정되어 있습니다.
태그 항목
준언어(Paralanguage) — 말과 함께 발생하는 비음성 소리.
감정(Emotion) — 문맥과 운율에서 포착된 전달의 감정적 톤.
팟캐스터에게 중요한 이유
대부분의 팟캐스트 워크플로우에서 태그는 세 가지 실용적인 목적을 수행합니다. 첫째, 전사본을 쇼 노트 소스로 더 유용하게 만듭니다. [laugh]나 [pause]를 포착한 전사본은 편집자에게 단순 텍스트 파일보다 훨씬 풍부한 자료를 제공합니다. 둘째, 긴 녹음 파일을 더 빠르게 탐색할 수 있게 합니다. [sigh]나 [emphasis] 순간을 훑어보며 다시 듣지 않고도 에피소드의 감정적으로 중요한 부분을 찾을 수 있습니다. 셋째, 무엇보다 특징적인 점은 이 태그들이 Fish Audio의 TTS 모델과 호환된다는 것입니다. 즉, 전사본을 별도의 재포맷 없이 음성 제작 워크플로우에 직접 입력할 수 있습니다.
태그의 실제 작동 모습을 보고 싶으신가요? 첫 오디오 파일 업로드하기 →
내보내기 형식 설명 — 어떤 형식이 필요하신가요?
Fish Audio STT는 세 가지 내보내기 형식을 지원합니다. 어떤 것을 사용할지는 전사본으로 무엇을 할지에 따라 달라집니다.
SRT는 비디오 콘텐츠를 배포하는 대부분의 팟캐스터에게 적합한 선택입니다. 가장 널리 지원되는 자막 형식으로, YouTube, Premiere Pro, Final Cut Pro 및 대부분의 비디오 플랫폼과 호환됩니다.
VTT (WebVTT)는 웹 전용 형식입니다. 본인의 웹사이트에 비디오를 삽입하고 인라인 단어 타이밍이 필요한 경우 사용하십시오.
JSON은 자막 변환이 없는 원시 STT 데이터를 제공합니다. 전사본을 다른 도구에 입력하거나 맞춤형 프로그램을 구축할 때 사용하십시오.
내보내기 옵션
SRT 또는 VTT로 내보낼 때 네 가지 추가 설정을 할 수 있습니다.
-
Include tags —
[pause]및[sigh]와 같은 괄호 안의 이벤트를 자막 파일에 유지합니다. 깔끔한 자막을 원하면 끄고, 표현력 있는 메타데이터를 보존하려면 켜두십시오. -
Include speaker — 감지된 화자 레이블(SPK_0, SPK_1)을 각 자막 큐 앞에 붙입니다. 다중 화자 에피소드에 유용합니다.
-
Punctuation — 내보낼 텍스트에 문장 부호를 유지합니다. 추가 처리를 위해 깨끗한 토큰 스트림이 필요한 경우 끄십시오.
-
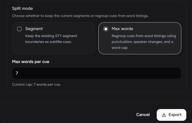
Split mode — Segment(기존 STT 경계 유지) 또는 Max words(단어 수, 문장 부호 및 화자 변경에 따라 큐 재그룹화) 중 선택합니다. 큐당 최대 7개 단어로 제한한 Max words 모드는 빠른 대화에서 더 읽기 쉬운 자막을 생성하는 경향이 있습니다.
화자 감지 — 진행자와 게스트 구분하기
팟캐스트 인터뷰 및 패널 토론의 경우 화자 감지는 팟캐스트 전사 도구가 제공할 수 있는 가장 유용한 기능 중 하나입니다. Fish Audio는 다인 녹음에서 화자를 자동으로 분리합니다. 전사 뷰어의 각 세그먼트에는 오디오에서 감지된 고유한 음성에 따라 SPK_0, SPK_1 등으로 레이블이 지정됩니다.
작업을 생성할 때 number of speakers를 'Auto'로 두거나 수동으로 설정할 수 있습니다. 정확한 인원수를 설정하면 한 화자가 다른 화자보다 현저히 조용한 녹음에서도 더 깔끔한 화자 경계를 생성하는 경향이 있습니다.
내보낼 때 Include speaker를 활성화하면 각 자막 큐의 접두사로 화자 레이블이 추가됩니다. 이를 통해 화자별로 전사본을 검색, 편집 또는 재포맷하기가 쉬워지며, 쇼 노트를 위해 인용문을 추출하거나 주요 대화만 편집할 때 유용합니다.
참고: 화자 감지 및 화자 레이블이 지정된 전사본은 Fish Audio 웹 인터페이스에서 사용할 수 있습니다. Include speaker가 활성화된 경우 SRT, VTT 및 JSON 형식 내보내기 시 화자 레이블이 함께 포함됩니다.
팟캐스트 전사 비용은 얼마인가요?
Fish Audio STT는 처리된 오디오 분당 300 크레딧의 비율로 요금이 청구됩니다.
무료 계정은 매달 8,000 크레딧을 받으며, 이는 약 26분의 오디오를 처리할 수 있는 양입니다. 이는 짧은 형식의 에피소드나 몇 개의 인터뷰 세그먼트를 처리하기에 충분합니다.
웹 인터페이스는 작업을 확정하기 전에 정확한 예상 크레딧을 보여주므로 예상치 못한 비용이 발생하지 않습니다.
팀 또는 대량 생산의 경우 유료 플랜에 더 큰 크레딧 풀이 포함되어 있습니다. fish.audio/plan/에서 전체 요금 체계를 확인하세요.
다음 팟캐스트 에피소드를 몇 분 만에 전사해 보세요. 무료로 전사 시작하기 →
Fish Audio vs 기타 팟캐스트 전사 도구
최고의 팟캐스트 전사 도구를 찾는 많은 팟캐스터들은 단순 텍스트 전사본이 필요한지, 아니면 감정 태그 및 다중 형식 내보내기와 같은 풍부한 메타데이터가 필요한지에 따라 선택이 달라진다는 것을 알게 됩니다. Fish Audio와 다른 인기 옵션의 비교는 다음과 같습니다.
| 기능 | Fish Audio | Otter.ai | Happy Scribe | Adobe Podcast |
|---|---|---|---|---|
| 자동 감정 태그 | ✅ | ❌ | ❌ | ❌ |
| 준언어 태그 | ✅ | ❌ | ❌ | ❌ |
| 화자 감지 | ✅ | ✅ | ✅ | ✅ |
| SRT 내보내기 | ✅ | ✅ | ✅ | ❌ |
| VTT 내보내기 | ✅ | ❌ | ✅ | ❌ |
| JSON 내보내기 | ✅ | ❌ | ❌ | ❌ |
| TTS / Studio 통합 | ✅ | ❌ | ❌ | ❌ |
| 지원 언어 | 100+ | 다국어 | 120+ | 제한적 |
| 무료 티어 | ✅ 월 8,000 크레딧 | ✅ 월 300분 | ✅ 제한적 | ✅ |
데이터 출처: 2026년 3월 기준 Otter.ai, Happy Scribe, 및 Adobe Podcast.
대부분의 팟캐스트 전사 도구는 일반 텍스트 출력물을 제공하는 데 집중합니다. Fish Audio는 전사본 내에 직접 감정 및 준언어 태그를 삽입하는 몇 안 되는 도구 중 하나이며, Studio 통합을 통해 전사본을 음성 제작 워크플로우로 연결하는 몇 안 되는 도구입니다.
쇼 노트나 SEO 콘텐츠를 위한 깨끗한 일반 텍스트가 필요하다면 이 도구들 중 어떤 것을 사용해도 좋습니다. 태그가 포함된 전사본, 다중 형식 내보내기 또는 전사본에서 음성 제작으로 이어지는 경로가 필요하다면 Fish Audio가 가장 완벽한 옵션입니다.
팟캐스터들에게 유용한 또 다른 옵션은 AI 플랫폼인 Podsqueeze입니다. 이 플랫폼은 팟캐스트 에피소드를 쇼 노트, 타임스탬프, 요약, 소셜 포스트, 뉴스레터 및 기타 재가공된 콘텐츠로 변환하는 데 도움을 줍니다. 녹음 후 시간을 절약하고 각 에피소드를 시청자를 위한 여러 콘텐츠 자산으로 전환하려는 크리에이터에게 특히 유용합니다.
다음 단계 — 전사본에서 Studio로
태그가 지정된 전사본은 단순한 문서 그 이상입니다. 이는 이미 어떻게 들려야 하는지 알고 있는 스크립트입니다.
Fish Audio가 팟캐스트 전사본에 삽입하는 [calm, reflective], [breath], [determined], [pause]와 같은 태그들은 Fish Audio의 S2 TTS 모델과 동일한 형식을 사용합니다. 즉, 전사본을 재포맷 없이 음성 생성 파이프라인에 직접 입력할 수 있습니다.
Fish Audio Studio는 여기서 한 걸음 더 나아갑니다. Studio에서 태그가 지정된 스크립트는 완전히 편집 가능한 음성 프로젝트가 됩니다. 챕터별 편집, 음성 모델 교체, 단어 단위의 전달력 조정, 멀티트랙 오디오 제작이 가능하며, 원본 녹음의 표현력 있는 메타데이터를 그대로 유지할 수 있습니다.
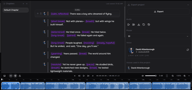
STT에서 Studio로의 직접 가져오기는 곧 출시될 기능입니다. 전사본 형식은 이미 호환됩니다. STT 출력물의 태그는 Studio가 읽는 태그와 동일합니다. 기능이 출시되면 한 단계만으로 가져오기가 가능해질 것입니다.
무료로 팟캐스트 전사 시작하기 → — 또는 제작 준비가 되었다면 Fish Audio Studio 둘러보기를 해보세요.
관련 항목:
자주 묻는 질문
가장 좋은 무료 팟캐스트 전사 도구는 무엇인가요?
Fish Audio의 팟캐스트 전사 도구는 얼마나 정확한가요?
Fish Audio는 여러 명의 화자를 전사할 수 있나요?
Fish Audio는 어떤 내보내기 형식을 지원하나요?
전사에 시간이 얼마나 걸리나요?
계정 없이 Fish Audio STT를 사용할 수 있나요?
Fish Audio는 어떤 언어를 지원하나요?
Fish Audio는 어떤 오디오 형식을 지원하나요?
Sabrina is part of Fish Audio's support and marketing team, helping users get the most out of AI voice products while turning launches, updates, and customer insights into clear, practical content.
Sabrina Shu의 더 많은 글 보기