5 modèles, 22 personnes, 1 an


Fish Audio a levé 52 millions de dollars en financement d'amorçage. Comment un projet passion sur une seule 4090 est devenu ceci, et ce que nous construisons ensuite. Lisez notre histoire.
Aujourd'hui marque une nouvelle étape incroyable pour Fish Audio. Nous annonçons un financement d'amorçage de 52 millions de dollars à l'occasion de notre premier anniversaire. Merci à Coreline Ventures et Capital Today, qui ont mené ce tour de table, avec la participation de 359 Capital, Play Time, HF0, 645 Ventures, Parable, Carya Venture Partners, Alphalist Partners, ainsi qu'aux business angels qui ont investi quand il n'y avait pas encore grand-chose à voir.
La synthèse vocale (text-to-speech) est devenue satisfaisante il y a environ une décennie, tant que vous n'aviez besoin que d'une seule phrase. Les fissures apparaissent dès la dixième. Toute la catégorie échoue au même endroit, pour la même raison : prononcer les mots correctement et assurer une interprétation juste sont deux problèmes différents, et presque tout le monde n'a travaillé que sur le premier.
Mes années passées dans l'IA vocale chez Amazon Alexa et Meta m'ont appris là où le TTS traditionnel s'arrête : une voix conçue pour lire n'apprend jamais à interpréter. Nous avons donc commencé par l'autre extrémité. Fish Audio n'est pas un meilleur assistant vocal. C'est la couche vocale pour tout ce qui suivra.

La 4090
Shijia Liao, notre scientifique en chef, est parvenu à la même conclusion par un chemin différent. En tant qu'ingénieur de recherche chez NVIDIA travaillant sur la vidéo, il passait son temps libre à regarder des streams de VTubers et ne supportait pas de voir à quel point les voix semblaient sans vie. Il a commencé à entraîner des modèles sur une seule 4090 dans sa chambre, faisant très tôt le pari d'une architecture autorégressive double que le reste de l'industrie ne rattraperait que deux ans plus tard. Ce travail est devenu le fondement de S2.
Ce que nous avons accompli en 1 an
- Cinq modèles audio de pointe lancés. Quatre pour le text-to-speech, un pour le speech-to-text.
- L'équipe est passée de 3 à 22 personnes, et nous recrutons toujours.
- De zéro à 21 millions de dollars de revenus annuels récurrents.
- Plus de 8 millions de créateurs, développeurs et entreprises sur la plateforme.
- Plus de 2 millions de modèles de voix dans la bibliothèque communautaire.
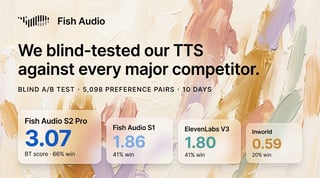
- S2.1 Pro, préféré par 66 % des auditeurs face aux principaux concurrents lors de tests d'écoute à l'aveugle.
- Plus de 83 langues avec une cadence native et un contrôle des émotions au niveau des mots via plus de 15 000 commandes en langage naturel.
La communauté a construit le modèle
Nous effectuons le post-entraînement sur la base des préférences réelles des utilisateurs, ce qui signifie que le modèle s'améliore à mesure que les gens l'utilisent davantage. C'est pourquoi nous excellons en anglais accentué, en mandarin, en japonais, en coréen et en espagnol, là où les modèles entraînés principalement sur l'anglais américain standard s'effondrent. Cette capacité est née d'utilisateurs exploitant l'outil dans des langues, des accents et des cas particuliers que nous n'aurions jamais pensé à tester.
Fish Speech est passé d'un dépôt à une entreprise grâce aux développeurs de jeux, aux fans d'anime et aux personnes doublant des personnages pour le plaisir. Dès le départ, nous avons cru en la transparence et l'ouverture, et en la volonté de rendre une IA vocale expressive et de haute qualité accessible à tous.
Et huit millions d'entre vous nous ont fait confiance pour y parvenir.
Le modèle auquel les entreprises font désormais confiance
Cette confiance est la raison pour laquelle les entreprises se tournent également vers Fish Audio. En comptant les développeurs, le secteur entreprise représente désormais les deux tiers de nos revenus.
Nous leur offrons une disponibilité, une latence et une posture de sécurité capable de satisfaire les processus d'achat les plus exigeants : déploiement sur site, politiques de zéro rétention de données et configurations conformes à la norme HIPAA, intégrés dès le départ. S2.1 Pro remporte déjà des tests d'écoute à l'aveugle contre les modèles leaders, traite plus de 8 000 jetons par seconde sur un seul H200, et tient la route dans des langues où les modèles réglés pour un seul dialecte finissent par échouer discrètement.
Les clients en entreprise viennent à nous parce que réussir l'interprétation, et pas seulement les mots, est exactement le problème que nous avons voulu résoudre. C'est cette même mission que nous pouvons désormais mener encore plus loin.
Et ensuite ?
Le text-to-speech n'a jamais été la destination finale. C'était l'étape que nous pouvions construire en premier avec un seul GPU pour prouver notre théorie : l'interprétation compte autant que les mots, et personne ne s'en occupait.
Maintenant, nous nous attaquons au reste. Modèle de langage pour la compréhension audio (Audio LM) et speech-to-speech. Nous renforçons également nos outils pour développeurs et notre API, élargissons notre équipe entreprise et approfondissons nos partenariats avec des acteurs comme LiveKit et Retell pour intégrer une voix expressive dans plus d'endroits, plus rapidement.
Gratuit jusqu'en août
Pour célébrer cette étape majeure, S2.1 Pro est gratuit pour tous les développeurs via API jusqu'à la fin du mois d'août. C'est le même modèle que celui payé par nos clients entreprises. Nous offrons également 50 % de réduction sur les forfaits créateurs et 3 mois gratuits si vous migrez depuis un autre fournisseur.
Si nous pouvons faire cela, c'est pour des raisons techniques, et c'est notre équipe de recherche qui en mérite le crédit. Ils ont reconstruit toute notre pile d'inférence cette année : noyaux FP8 personnalisés, plus de 8 000 jetons par seconde sur un seul H200. Cela a réduit notre coût par requête suffisamment pour que proposer le modèle gratuitement devienne une stratégie viable.
Merci
Il y a un an, Fish Audio était un projet passion né dans notre salon. Tous ceux qui ont entraîné une voix, doublé un personnage, construit sur l'API ou parié sur nous avant qu'il n'y ait grand-chose à voir — ce succès est autant le vôtre que le nôtre.
Nous avons fait beaucoup d'erreurs en cours de route. Nous allons bientôt avoir les ressources pour faire beaucoup plus de choses correctement.
À l'année deux.
Rissa is the CEO and co-founder of Fish Audio, pushing breakthroughs in AI voice technology. Find her latest work at @rissa_cao.
Lire plus de Rissa Cao