Herramienta de transcripción de podcasts: Cómo transcribir tu podcast con Fish Audio

La herramienta de transcripción de podcasts de Fish Audio convierte audio en texto con etiquetas automáticas de emoción, etiquetas de hablante y marcas de tiempo; luego exporta a SRT, VTT o JSON. Nivel gratuito disponible. No requiere programación.
Marzo de 2026 | Fish Audio STT ya está disponible en fish.audio/app/speech-to-text
Cada episodio de podcast que publicas sin una transcripción es una oportunidad perdida de atraer tráfico. Una transcripción hace que tu episodio sea indexable en Google, te permite crear notas del programa (show notes) con un solo clic y te ayuda a generar subtítulos automáticamente para YouTube, tu sitio web o cualquier otro canal de distribución. Además, hace que tu contenido sea accesible para personas con discapacidad auditiva. Los editores de podcasts, equipos de medios y creadores de YouTube confían en las transcripciones para generar contenido SEO, archivos de búsqueda y páginas de episodios accesibles. La mayoría de las herramientas de transcripción de podcasts te entregan un bloque de texto plano y dan el trabajo por terminado. La herramienta de transcripción de Fish Audio va más allá: cada transcripción incluye etiquetas automáticas de emoción y paralenguaje, etiquetas de hablante, marcas de tiempo y tres formatos de exportación. Esta guía te explica todo el flujo de trabajo, desde la carga hasta la exportación, en unos tres minutos.
¿Qué hace que una herramienta de transcripción de podcasts sea buena?
Antes de elegir cualquier herramienta de transcripción, es útil saber qué estás evaluando realmente. Una buena herramienta de transcripción de podcasts debe ofrecer cuatro cosas:
-
Alta precisión de transcripción en diferentes acentos, calidades de audio y entornos de grabación.
-
Identificación de hablantes para que puedas distinguir al anfitrión del invitado en la transcripción.
-
Múltiples formatos de exportación: como mínimo SRT para subtítulos de video e, idealmente, VTT y JSON también.
-
Precios transparentes y asequibles con un nivel gratuito que sea realmente útil para un episodio real.
Fish Audio STT admite más de 100 idiomas, acepta 24 formatos de audio y video, y etiqueta automáticamente eventos de emoción y paralenguaje de forma integrada, sin necesidad de anotación manual. El modelo de voz a texto (STT) está optimizado para audio conversacional y grabaciones con múltiples hablantes como podcasts, entrevistas y discusiones en vivo. Así es como funciona en la práctica.
Cómo transcribir tu podcast con Fish Audio: paso a paso
Tiempo necesario: ~3 minutos Herramientas necesarias: Archivo de audio (MP3, MP4, WAV, M4A y más) Resultado: Transcripción etiquetada + archivo de subtítulos listo para exportar
Paso 1: Abrir Fish Audio STT
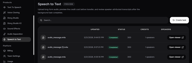
Ve a fish.audio/app/speech-to-text. Verás tu historial de tareas: todas las transcripciones anteriores con nombre de archivo, fecha, estado, créditos utilizados y recuento de hablantes. Haz clic en Create task para iniciar una nueva transcripción.
Paso 2: Sube tu episodio y configura los hablantes
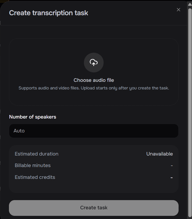
En la ventana "Create transcription task", sube tu archivo de audio o video. Fish Audio acepta los formatos más importantes: MP3, MP4, WAV, FLAC, M4A, OGG, MOV, AVI, WEBM y más.
En number of speakers, déjalo en "Auto" si no estás seguro de cuántas personas hay en la grabación. Fish Audio detectará a los hablantes automáticamente. Si conoces el número exacto (por ejemplo, dos para un formato estándar de anfitrión e invitado), puedes configurarlo manualmente para obtener etiquetas de hablante más precisas.
Antes de confirmar, la interfaz te muestra la duración estimada, los minutos facturables y los créditos estimados para esta tarea. No se te cobrará hasta que hagas clic en Create task.
Paso 3: Revisa tu transcripción
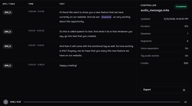
Una vez finalizada la tarea, haz clic en Open viewer. La transcripción se muestra en tres columnas: SPK/TAGS (etiqueta del hablante), TIME (rango de tiempo) y TEXT (la transcripción con etiquetas integradas).
Cada segmento tiene una marca de tiempo con precisión de segundos. Los eventos de emoción y paralenguaje aparecen como etiquetas púrpuras directamente dentro del texto: verás cosas como [pause], [sigh], [emphasis] y [breath] en el punto exacto de la grabación donde ocurrieron.
Haz clic en cualquier segmento para reproducir esa parte del audio directamente en el navegador. Esto facilita la verificación de la precisión o el control de momentos específicos sin tener que escuchar todo el archivo.
El panel de control derecho muestra un resumen: duración total, número de hablantes detectados, número de segmentos y la confirmación de que la separación de voz y el etiquetado de eventos de audio están activados.
Paso 4: Exporta en tu formato
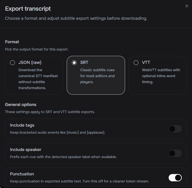
Haz clic en Export en la parte inferior derecha del panel de control. Elige tu formato y configura las opciones de exportación antes de descargar.
¿Listo para transcribir tu primer episodio? Inicia una tarea de transcripción gratuita →
Etiquetas automáticas: Lo que Fish Audio captura y otras herramientas pasan por alto
Aquí es donde la herramienta de transcripción de podcasts de Fish Audio se diferencia más claramente de las alternativas.
Cuando alguien suspira antes de responder a una pregunta, se ríe a mitad de una frase, hace una pausa para dar énfasis o respira de forma audible, las herramientas de transcripción estándar ignoran todo eso. Obtienes las palabras, despojadas de todo lo demás.
Fish Audio incrusta estos eventos como etiquetas integradas en el punto exacto donde ocurren en la transcripción. Estas etiquetas se generan automáticamente, sin anotación manual ni pasos de postprocesamiento. El panel de control muestra Tag audio events: On por defecto.
Qué se etiqueta
Paralenguaje: sonidos no verbales que ocurren junto al habla.
Emoción: el tono afectivo de la locución, capturado a partir del contexto y la prosodia.
Por qué esto es importante para los podcasters
En la mayoría de los flujos de trabajo de podcasting, las etiquetas sirven para tres propósitos prácticos. Primero, hacen que tu transcripción sea más útil para las notas del programa: una transcripción que captura [laugh] y [pause] le da a tu editor un material más rico para trabajar que un archivo de texto plano. Segundo, permiten navegar más rápido por grabaciones largas: puedes buscar momentos de [sigh] o [emphasis] para encontrar partes emocionalmente significativas del episodio sin volver a escucharlo. Tercero, y más distintivo, estas etiquetas son compatibles con el modelo TTS de Fish Audio, lo que significa que una transcripción puede alimentar directamente un flujo de producción de voz sin necesidad de reformatear.
¿Quieres ver las etiquetas en acción? Sube tu primer archivo de audio →
Formatos de exportación explicados: ¿Cuál necesitas?
Fish Audio STT admite tres formatos de exportación. Cuál utilizar depende de lo que vayas a hacer con la transcripción después.
SRT es la elección correcta para la mayoría de los podcasters que distribuyen contenido de video. Es el formato de subtítulos más compatible, aceptado por YouTube, Premiere Pro, Final Cut Pro y la mayoría de las plataformas de video.
VTT (WebVTT) es el formato nativo de la web; úsalo cuando vayas a insertar video en tu propio sitio y necesites tiempos de palabras integrados.
JSON te ofrece la salida bruta de STT sin transformaciones de subtítulos. Úsalo si vas a introducir la transcripción en otra herramienta o si estás construyendo algo personalizado.
Opciones de exportación
Al exportar SRT o VTT, tienes cuatro ajustes adicionales:
-
Include tags: mantiene los eventos entre corchetes como
[pause]y[sigh]en el archivo de subtítulos. Desactívalo para obtener subtítulos limpios; déjalo activado si quieres conservar los metadatos expresivos. -
Include speaker: antepone a cada segmento de subtítulo la etiqueta del hablante detectado (SPK_0, SPK_1). Útil para episodios con varios participantes.
-
Punctuation: mantiene la puntuación en el texto exportado. Desactívalo para un flujo de tokens más limpio si vas a realizar un procesamiento posterior.
-
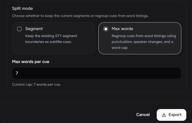
Split mode: elige entre "Segment" (mantiene los límites existentes de STT) o "Max words" (reagrupa los segmentos por recuento de palabras, puntuación y cambios de hablante). "Max words" con un límite de 7 palabras por segmento suele producir subtítulos más legibles para el habla rápida.
Detección de hablantes: Diferenciar al anfitrión del invitado
Para entrevistas de podcast y mesas redondas, la detección de hablantes es una de las funciones más útiles que puede ofrecer una herramienta de transcripción. Fish Audio separa automáticamente a los hablantes en grabaciones de varias personas. Cada segmento en el visor de transcripción está etiquetado como SPK_0, SPK_1, etc., correspondiendo a las distintas voces detectadas en el audio.
Al crear una tarea, puedes dejar el number of speakers en "Auto" o configurarlo manualmente. Establecer el número exacto suele producir límites de hablante más limpios, especialmente en grabaciones donde un hablante es significativamente más silencioso que otro.
Al exportar, activar Include speaker añade la etiqueta de hablante como prefijo a cada subtítulo. Esto facilita la búsqueda, edición o reformateo de transcripciones por hablante, lo cual es útil si estás extrayendo citas para notas del programa o editando una transcripción para resaltar intercambios clave.
Nota: La detección de hablantes y las transcripciones con etiquetas de hablante están disponibles en la interfaz web de Fish Audio. Las etiquetas de hablante se incluyen en las exportaciones SRT, VTT y JSON cuando la opción "Include speaker" está activada.
¿Cuánto cuesta transcribir un podcast?
Fish Audio STT se factura por minuto de audio procesado a razón de 300 créditos por minuto.
Las cuentas gratuitas reciben 8.000 créditos al mes, lo que es suficiente para aproximadamente 26 minutos de audio. Esto cubre un episodio corto o varios segmentos de entrevistas.
La interfaz web te muestra los créditos estimados exactos antes de confirmar una tarea, por lo que no hay sorpresas.
Para equipos o producciones de gran volumen, los planes de pago incluyen paquetes de créditos más amplios. Consulta el desglose completo de precios en fish.audio/plan/.
Transcribe tu próximo episodio de podcast en minutos. Empieza a transcribir gratis →
Fish Audio frente a otras herramientas de transcripción de podcasts
Muchos podcasters que buscan la mejor herramienta de transcripción descubren que la elección correcta depende de si necesitan transcripciones de texto plano o metadatos más ricos como etiquetas de emoción y exportación multiformato. Así es como se compara Fish Audio con otras opciones populares:
| Función | Fish Audio | Otter.ai | Happy Scribe | Adobe Podcast |
|---|---|---|---|---|
| Etiquetas automáticas de emoción | ✅ | ❌ | ❌ | ❌ |
| Etiquetas de paralenguaje | ✅ | ❌ | ❌ | ❌ |
| Detección de hablantes | ✅ | ✅ | ✅ | ✅ |
| Exportación SRT | ✅ | ✅ | ✅ | ❌ |
| Exportación VTT | ✅ | ❌ | ✅ | ❌ |
| Exportación JSON | ✅ | ❌ | ❌ | ❌ |
| Integración TTS / Studio | ✅ | ❌ | ❌ | ❌ |
| Idiomas | 100+ | Multilingüe | 120+ | Limitado |
| Nivel gratuito | ✅ 8.000 créd/mes | ✅ 300 min/mes | ✅ Limitado | ✅ |
Datos obtenidos de Otter.ai, Happy Scribe, y Adobe Podcast a fecha de marzo de 2026.
La mayoría de las herramientas de transcripción se centran en entregar texto plano. Fish Audio es una de las pocas que incrusta etiquetas de emoción y paralenguaje directamente en la transcripción, y una de las pocas herramientas que conecta la transcripción con un flujo de producción de voz mediante la integración con Studio.
Si necesitas texto plano limpio para notas del programa o contenido SEO, cualquiera de estas herramientas funcionará. Si necesitas transcripciones etiquetadas, exportación multiformato o un camino directo de la transcripción a la producción de voz, Fish Audio es la opción más completa.
Otra opción útil para los podcasters es Podsqueeze, una plataforma de IA que ayuda a convertir episodios de podcast en notas del programa, marcas de tiempo, resúmenes, publicaciones en redes sociales, boletines informativos y otros contenidos reutilizables. Es especialmente útil para los creadores que quieren ahorrar tiempo después de grabar y convertir cada episodio en múltiples activos de contenido para su audiencia.
Próximos pasos: De la transcripción al Studio
Una transcripción etiquetada es más que un documento. Es un guion que ya sabe cómo debe sonar.
Las etiquetas que Fish Audio incrusta en tu transcripción de podcast —[calm, reflective], [breath], [determined], [pause]— utilizan el mismo formato que el modelo TTS S2 de Fish Audio. Eso significa que una transcripción puede alimentar directamente un flujo de generación de voz sin necesidad de reformatear.
Fish Audio Studio lleva esto más allá. En Studio, los guiones etiquetados se convierten en proyectos de voz totalmente editables: puedes editar por capítulo, cambiar modelos de voz, ajustar la locución a nivel de palabra y producir audio multipista, todo ello conservando los metadatos expresivos de tu grabación original.
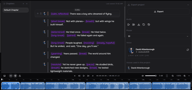
La importación directa de STT a Studio es una función que estará disponible próximamente. El formato de transcripción ya es compatible: las etiquetas en tu salida de STT son las mismas etiquetas que lee Studio. La importación será un proceso de un solo paso una vez que se lance la función.
Empieza a transcribir tu podcast gratis → — o Explora Fish Audio Studio si ya estás listo para producir.
Relacionado:
Preguntas Frecuentes
¿Cuál es la mejor herramienta gratuita de transcripción de podcasts?
¿Qué tan precisa es la herramienta de transcripción de podcasts de Fish Audio?
¿Puede Fish Audio transcribir a varios hablantes?
¿Qué formatos de exportación admite Fish Audio?
¿Cuánto tiempo tarda la transcripción?
¿Puedo usar Fish Audio STT sin una cuenta?
¿Qué idiomas admite Fish Audio?
¿Qué formatos de audio acepta Fish Audio?
Sabrina is part of Fish Audio's support and marketing team, helping users get the most out of AI voice products while turning launches, updates, and customer insights into clear, practical content.
Leer más de Sabrina Shu